Alpha Mohamed KABA
Data Science et sa méthodologie
Qu'est-ce que la science des données ? Une question que beaucoup de gens se posent, et pour cause, la science des données est un domaine relativement nouveau. Dans cet article, nous discuterons de ce qu'est la science des données ainsi que la méthodologie utilisée par les data scientists (scientifiques de données) pour résoudre un problème. A la fin de cet article, vous aurez une compréhension claire de ce qui est la data science et sa méthodologie.
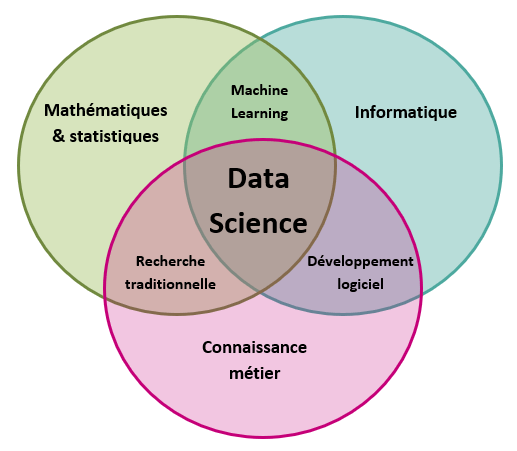
La data science, en termes simples, peut être définie comme une approche permettant d'acquérir des connaissances sur un sujet en utilisant des données, des algorithmes et la technologie. Les domaines d'application de science sont notamment la santé, la finance, la vente au détail, la banque, l'assurance, etc. Parfois, les connaissances sont également appelées informations ou informations exploitables. Les méthodes scientifiques populaires telles que l'établissement d'hypothèses, l'expérimentation pour tester l'hypothèse et l'établissement de l'hypothèse comme vraie ou non sont également valables pour la science des données. La science des données peut être considérée comme une extension de la science mais avec une plus grande puissance en raison du levier de la technologie liée au big data, de l'infrastructure informatique pour stocker et traiter les données, des outils de programmation, etc.
La méthodologie appliquée par les data scientists consiste en dix étapes qui sont les suivantes.
1. Compréhension commerciale :
Chaque projet, quelle que soit sa taille, commence par la compréhension de l'entreprise qui a besoin de la solution d'analyse, celle-ci joue un rôle essentiel dans cette phase. L’entreprise définit le problème, les objectifs du projet et les exigences de la solution d'un point de vue commercial. Il s'agit de la première étape de toute méthodologie de science des données. A cette première étape, nous devrions avoir la clarté du problème exact que nous allons résoudre.
2. Compréhension analytique :
Une fois qu'un problème métier a été clairement identifié, le Data Scientist (scientifique des données) peut définir l'approche analytique. Pour ce faire, le problème doit être exprimé dans le contexte des techniques d'apprentissage statistique et d'apprentissage automatique. Cela permet au Data Scientist d’identifier l’approche permettant d'atteindre le résultat souhaité. Les approches peuvent être de 4 types : approche descriptive (état actuel et informations fournies), approche diagnostique (c’est-à-dire analyse statistique, ce qui se passe et pourquoi cela se produit), approche prédictive (elle prévoit les tendances ou la probabilité d’événements futurs) et prescriptive approche (comment le problème devrait être résolu en fait).
3. Exigences en matière de données :
Selon l'approche analytique ci-dessus, nous déterminons les besoins en données car les méthodes d'analyse à utiliser nécessitent un contenu, des formats et des représentations de données spécifiques, basés sur la connaissance du domaine. A cette étape, il convient de trouver les réponses à des questions telles que « comment », « où », « pourquoi », « qui », « quoi » et « quand ».
4. Collecte de données :
Le Data Scientist identifie et collecte les données (structurées, non structurées et semi-structurées) qui sont pertinentes pour le problème. Si le scientifique des données trouve des lacunes dans les données collectées, il peut collecter plus de données ou supprimer les données non pertinentes.
5. Compréhension des données :
A ce stade, les statistiques descriptives et les techniques de visualisation peuvent aider un data scientist à comprendre le contenu des données, à évaluer leur qualité et à obtenir des informations initiales sur les données. Cette étape peut conduire à revenir à l’étape précédente pour correction si nécessaire.
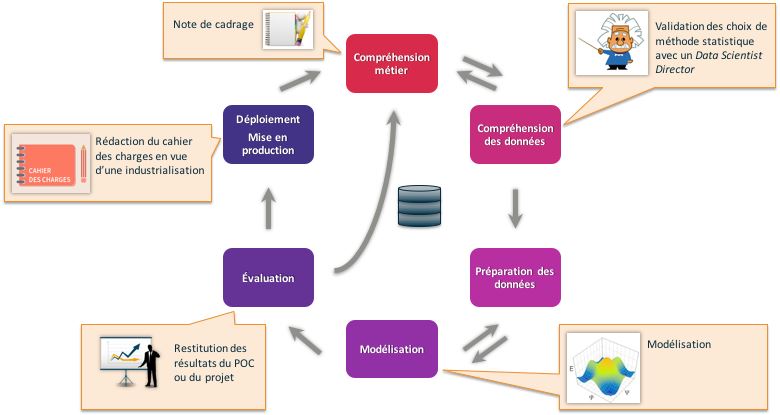
6. Préparation des données :
L'étape de préparation des données comprend toutes les activités utilisées pour créer l'ensemble de données utilisé lors de la phase de modélisation. Cela comprend le nettoyage des données, l’intégration de données provenant de plusieurs sources, la transformation et la normalisation de données.
La phase de préparation des données est la plus longue. Cette phase représente 70% à 80% de la durée totale du projet.
7. Modélisation :
Dès la première version de l'ensemble de données préparé, les Data scientists utilisent un ensemble de données (données historiques dans lesquelles le résultat souhaité est connu) pour développer des modèles prédictifs ou descriptifs en utilisant l'approche analytique décrite précédemment. Le processus de modélisation est très itératif. Même si cela peut varier d’un problème à un autre.
8. Évaluation :
Le Data Scientist évalue la qualité du modèle et vérifie que le problème métier est traité de manière complète et adéquate. Pour ce faire, plusieurs mesures de diagnostic et d'autres résultats, tels que des tableaux et des graphiques, doivent être calculés à l'aide d'un ensemble de tests de modèles prédictifs.
9. Déploiement :
Une fois qu'un modèle satisfaisant a été développé et approuvé par l’entreprise, il sera mis en œuvre dans l'environnement de production ou dans un environnement de test comparable. Mais il faut noter que, la mise en œuvre d'un modèle dans un processus métier opérationnel implique généralement une grande expertise et des technologies très avancées.
10. Feedback :
Le feedback ou rétroaction, est essentiel pour le suivi des performances du modèle de production. Cette étape inclut les résultats collectés à partir du déploiement du modèle, les commentaires sur les performances du modèle de la part des utilisateurs et des clients, et les observations sur le fonctionnement du modèle dans l'environnement de production
Lorsque le modèle répond à toutes les exigences de l’entreprise, alors le projet de science des données prendra sa fin. Cependant, Le modèle ne doit pas être laissé sans traitement après avoir terminé ces dix étapes ; des mise à jour appropriées doivent être effectuées en fonction des commentaires et des nouveaux besoins. De plus des nouveaux modèles peuvent être examinés lorsque des nouvelles technologies émergent pour s'assurer que le modèle continue d'ajouter de la valeur.
Alpha Mohamed KABA

Je suis élève ingénieur généraliste à l'École Centrale Casablanca, avec une formation et expérience en Informatique, Data science et Intelligence Artificielle.