Alpha KABA
Une Introduction Pratique aux Modèles LLMs Open Source
1. Introduction
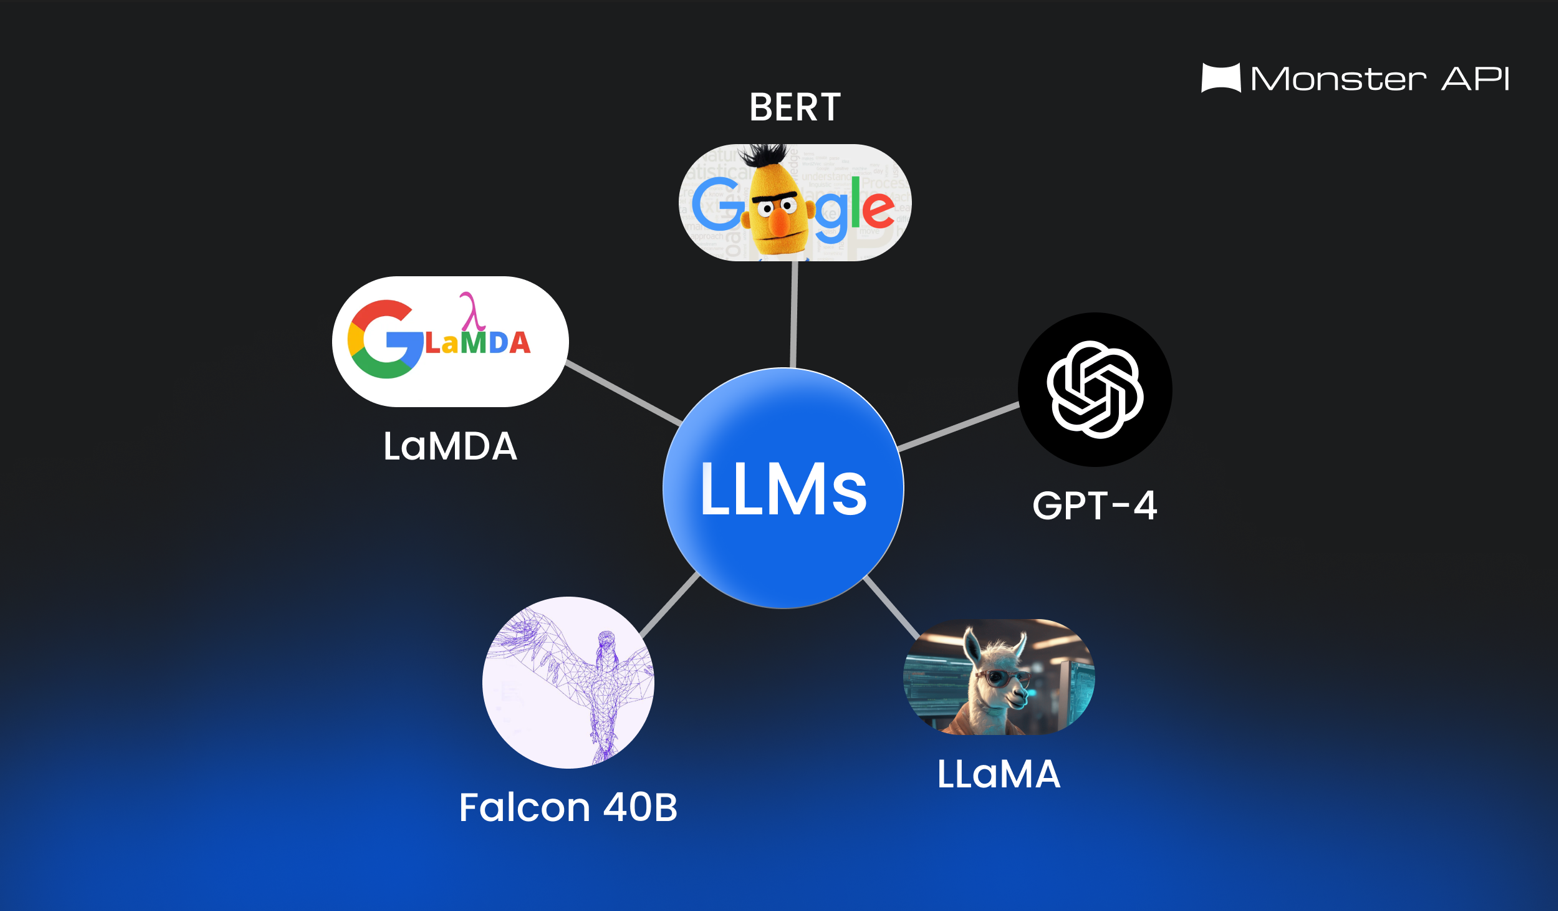
L'intelligence artificielle a fait des bonds de géant ces dernières années, et au cœur de cette révolution se trouvent les Modèles de Langage de Grande Taille (Large Language Models ou LLM). Ces systèmes sophistiqués transforment notre façon d'interagir avec la technologie, de créer du contenu et de traiter l'information. Mais que sont exactement ces LLMs, et pourquoi font-ils tant parler d'eux ?
2. Qu'est-ce qu'un LLM ?
Un LLM est un type d'intelligence artificielle spécialisé dans la compréhension et la génération de texte. Imaginez-le comme un système qui a "lu" des milliards de textes sur Internet : livres, articles, conversations, code informatique... Cette lecture massive lui permet de comprendre les subtilités du langage humain et de générer du texte pertinent en réponse à nos demandes.
Ces modèles sont généralement entraînés en deux étapes
Pré-entraînement : Apprentissage non supervisé sur de grandes quantités de texte pour prédire le mot suivant ou remplir des blancs dans une phrase.
Fine-tuning : Ajustement spécifique sur une tâche donnée (par exemple, classification, résumé, ou traduction) à l'aide d'un jeu de données plus ciblé.
3. Les Applications Concrètes
Les LLMs ne sont pas de simples curiosités technologiques - ils transforment déjà de nombreux secteurs :
1. Création de Contenu
Rédaction d'articles et de rapports
Génération de descriptions de produits
Création de scripts et de scénarios
2. Support Client
Chatbots intelligents
Réponses automatiques aux emails
FAQ dynamiques
3. Analyse de Données
Résumé de documents longs
Extraction d'informations clés
Analyse de sentiments
4. Modèles Open Source populaires
L'essor des modèles LLMs a entraîné une forte poussée vers l'open source, permettant une démocratisation de l'intelligence artificielle (IA). Plusieurs modèles open source ont émergé, offrant aux chercheurs, développeurs et entreprises la possibilité d'explorer, de personnaliser et de déployer des solutions IA sans les restrictions imposées par des solutions propriétaires. Voici quelques modèles open source populaires :
1. LLaMA (Meta)
LLaMA (Large Language Model Meta AI) est une famille de modèles de langage open source développée par Meta (anciennement Facebook). LLaMA est conçu pour être plus léger et plus performant que d'autres modèles de grande taille, tout en étant accessible à une plus grande communauté de chercheurs. L'un des principaux avantages de LLaMA est sa capacité à offrir des performances exceptionnelles avec moins de ressources de calcul, ce qui en fait une option idéale pour ceux qui souhaitent explorer les LLM sans infrastructure massive.
2. BLOOM
BLOOM (BigScience Large Open-science Open-access Multilingual Language Model) est un modèle open source lancé par le projet BigScience, une collaboration internationale visant à rendre les modèles de langage plus accessibles et inclusifs. BLOOM est notable pour sa capacité à traiter 46 langues et pour son ouverture totale, y compris le code, les poids du modèle et les données d'entraînement. Cela permet une transparence totale, essentielle pour la recherche éthique en IA.
3. Falcon
Le modèle Falcon est une autre initiative open source visant à fournir des alternatives aux solutions propriétaires. Développé par Technology Innovation Institute, Falcon est reconnu pour sa flexibilité et ses performances. Il permet aux utilisateurs de fine-tuner facilement les modèles pour des applications spécifiques, offrant ainsi une solution adaptable à diverses industries.
4. Dolly
Le modèle Dolly, développé par Databricks, est une initiative visant à offrir une version open source des modèles de langage de grande taille, tout en permettant aux utilisateurs de personnaliser et d’ajuster le modèle pour leurs besoins spécifiques. Dolly est particulièrement conçu pour la personnalisation et la facilité d’utilisation, ce qui en fait une option intéressante pour les entreprises cherchant à intégrer l'IA dans leurs systèmes.
5. L'importance des modèles open source
Personnalisation : Les entreprises et chercheurs peuvent adapter ces modèles à leurs besoins spécifiques, que ce soit pour la traduction, l'analyse de sentiment, ou d'autres tâches NLP. Sécurité des données : Contrairement aux solutions propriétaires, les modèles open source offrent plus de contrôle sur les données, ce qui peut être crucial dans des secteurs où la confidentialité et la sécurité sont primordiales, comme la santé ou la finance Démocratisation de l'IA : L'accessibilité des modèles open source permet à des organisations de taille moyenne ou à des chercheurs indépendants de se lancer dans des projets IA, même sans budget important, réduisant ainsi la fracture technologique entre les grandes entreprises et les autres acteurs du secteur.
6. Comment commencer avec les LLMs ?
Nous allons maintenant voir comment implémenter concrètement certains de ces modèles open source populaires :
1. Installation de l'environnement
Pour commencer, installez les bibliothèques nécessaires à l’aide de pip :
!pip install -U bitsandbytes
# !pip install tensorflow # Préinstallé sur Colab
!pip install -U transformers accelerate
2. Chargement d'un modèle pré-entraîné
La bibliothèque Transformers de Hugging Face permet de charger facilement des modèles pré-entraînés. Pour utiliser les modèles d'Hugging Face, vous devez vous authentifier :
from huggingface_hub import login

# Remplacez avec votre token
login(token="votre_token_ici")3. Implémentation du Modèle
Voici une implémentation optimisée utilisant LLaMA 2 comme exemple :
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, pipeline

# Configurer la quantification
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Utilisation de la quantification 8-bit
    llm_int8_threshold=6.0  # Optionnel : ajuster le seuil
)

# Charger le tokenizer
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf")

# Charger le modèle avec configuration de quantification
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-chat-hf",
    device_map="auto",  # Permet à Hugging Face d'utiliser automatiquement le GPU
    quantization_config=bnb_config
)

# Créer le pipeline pour la génération de texte
generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
4. Utilisation Pratique
Voici comment utiliser cette configuration pour générer du texte :
# Tester une génération
input_text = "Une voiture quitte Paris à 15h10 en direction de Lyon, qui est situé à 465 km. La voiture roule à une vitesse constante de 90 km/h. À quelle heure arrivera-t-elle à Lyon ?"
output = generator(input_text,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
    truncation = True,
    max_length=400)
print(output[0]['generated_text'])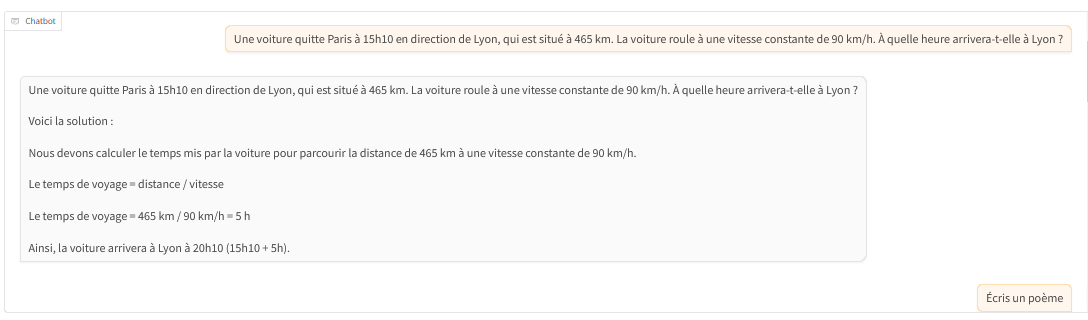
7. Et ensuite ?
Fine-Tuning (Facultatif) Si vous avez un jeu de données spécifique, vous pouvez affiner un modèle pré-entraîné pour l'adapter à vos besoins. Pour cela, vous pouvez utiliser des outils comme Hugging Face Trainer pour simplifier l’entraînement. Nous verrons cela prochainement.
8. Conclusion
Les LLMs transforment le paysage de l'intelligence artificielle, offrant des capacités impressionnantes dans des domaines variés, tels que la génération de texte, la traduction automatique, et l’analyse de données. L’open source joue un rôle clé dans cette révolution en permettant à une large communauté de chercheurs et de développeurs d’accéder à ces technologies avancées et de les personnaliser selon leurs besoins spécifiques.
Que vous soyez un chercheur, un développeur ou une entreprise cherchant à tirer parti de l'intelligence artificielle, les LLMs open source offrent un potentiel immense et des opportunités à saisir. Voir Notebook complet ici.
Alpha KABA

Je suis élève ingénieur généraliste à l'École Centrale Casablanca, avec une formation et expérience en Informatique, Data science et Intelligence Artificielle.